 Nostos
保存 arXiv 论文时,第一件事是分清摘要页与论文全文。Nostos 可以保留论文来源;在能够取得对应官方 HTML 的情况下,可进一步保存正文。只有摘要时,不应拿它当成已读过整篇论文。
摘要、HTML、PDF 先做选择
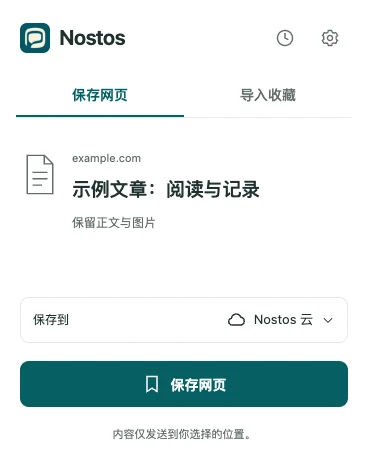
扩展实际界面,使用示例数据;用于辨认操作入口,不代表来源平台保存或上传已成功。
| 入口 | 适合做什么 | 不能据此声称什么 |
|---|---|---|
摘要页,路径含 /abs/ |
判断主题、作者、版本,保留论文线索 | 已保存完整方法和实验 |
官方 HTML,路径含 /html/ |
在可用时阅读与保存正文结构 | 所有论文都有 HTML 或所有公式已正确显示 |
| 回原站查阅论文排版与页面 | 当前这条摘要记录已包含 PDF 全文 |
不要手工把任意地址中的 abs 改成 html 就认定可用;从论文页面提供的官方入口进入同一论文版本。arXiv 的 HTML 可用性说明见 官方 HTML 阅读说明。
可重复的保存检查
- 选一篇你能打开官方 HTML 的论文,记下论文编号和版本。
- 在该 HTML 正文页打开 Nostos 扩展,点击“保存网页”。
- 保存后寻找原论文的一个章节标题,以及该章节下的一段正文。
- 对照一张图和一个公式;无法显示时回原文查阅,不自行推断缺失部分。
- 从 Nostos 的来源链接返回 arXiv,确认论文编号没有变化。
手机上先选HTML还是PDF
在手机浏览器打开论文的官方摘要页,先核对编号和版本,再跟随页面提供的HTML或PDF入口。HTML便于按段落阅读;需要对照原排版、页码或复杂公式时,保留同版本PDF作参照。如果官方页没有HTML,不要只把地址里的abs改成html就当作全文已经存在。
保存到Nostos后,在准备阅读的手机上打开,分别检查一个小标题、图注和你真正需要的公式。双栏PDF的缩放体验与HTML不同;浏览器里显示正常,也不能代替保存副本的检查。离线还需确认附件已到本机。
一个真实官方版本的核对入口
可从论文2402.08954v1摘要进入同版本官方HTML,标题为“HTML papers on arXiv: why it’s important, and how we made it happen”。2026-09-22读取HTML时,能定位到“PDF limitations”和“HTML”章节以及Figure 1;该版本包含四个figure和一个MathML节点。
这篇论文适合检查版本与图的身份,其中简单的数学示例不能代表复杂公式效果。对实际需要使用的公式,应与同版本PDF逐项比较分数、上下标和符号;原文仍是核对依据。
| 保存后发现的问题 | 先检查 | 处理方式 |
|---|---|---|
| 只有摘要 | 保存条目是否有正文小标题 | 打开官方HTML后保存,再核对具体段落 |
| 图注存在,图没有显示 | 图片是否已取得/在本机可用 | 联网检查附件;缺图时回官方原文 |
| 长公式或表格被截断 | 同版本官方HTML/PDF是否正常 | 用原文核验,不从不完整公式推导结论 |
| 论文内容与引用不同 | 编号与v1/v2等版本是否一致 | 回到引用所指版本,不混用图号或页码 |
用摘要能问什么,不能问什么
如果只保存了摘要,可以用它了解作者声称解决的问题或主要贡献;不应据此要求精确复述某张实验表或附录证明。只有目标段落实际保存在条目中,才能用它作为问答依据,重要结论仍需回原文核验。
是否等于 PDF 全文解析
不等于。本教程讨论 arXiv 的摘要与官方 HTML 内容,不能据此承诺任意 PDF、扫描版、附录或补充材料都能完整解析。公式渲染与媒体仍应和原文核验。
一般网页文章的保存方法见 跨来源文章收藏。